
اگر تا امروز چند ساعت وقت گذاشتهاید تا یک حل تمرین داده کاوی قابل فهم پیدا کنید، احتمالاً با دو نوع منبع روبهرو شدهاید: یا توضیحات نظری خشک که فقط فرمولها را تکرار میکنند، یا مثالهای ناقصی که مرحلهی مهم حل مسئله را نشان نمیدهند. نتیجه؟ زمان زیادی صرف میشود اما در عمل، هنگام مواجهه با یک دیتاست واقعی یا سؤال امتحانی، نمیدانید از کجا شروع کنید.
این مقاله دقیقاً برای حل همین مشکل نوشته شده است. در ادامه ۶ نمونه کامل و گامبهگام از حل تمرینهای دادهکاوی را میبینید که مهمترین روشهای این حوزه را پوشش میدهند: طبقهبندی، خوشهبندی، قوانین انجمنی، رگرسیون، تشخیص دادههای پرت و کاهش ابعاد. علاوه بر حل تمرینها، اشتباهات رایجی که اکثر دانشجویان مرتکب میشوند و نکاتی که معمولاً به آنها اشاره نمیشود را هم بررسی میکنیم.


چرا حل تمرین دادهکاوی، مهمتر از حفظکردن تئوری است؟
دادهکاوی یک درس کاملاً کاربردی است. یعنی تسلط واقعی شما نه با حفظ تعریف الگوریتمها، بلکه با توانایی انتخاب روش درست برای یک مسئلهی مشخص سنجیده میشود. بسیاری از دانشجویان فرمول K-Means یا آنتروپی درخت تصمیم را حفظ میکنند، اما وقتی با یک دیتاست جدید مواجه میشوند نمیدانند کدام الگوریتم مناسب است.
به همین دلیل، بهترین روش یادگیری این است که هر مفهوم را از طریق یک مثال حلشده و واقعی درک کنید، نه صرفاً از طریق فرمول. در ادامه دقیقاً همین کار را انجام میدهیم.
نکاتی که قبل از حل تمرین باید بدانید
پیش از ورود به مثالها، چند نکته کلیدی وجود دارد که معمولاً نادیده گرفته میشود:
- نوع مسئله را قبل از انتخاب الگوریتم مشخص کنید. آیا خروجی شما یک برچسب (کلاس) است، یک عدد پیوسته، یا گروهبندی بدون برچسب؟ این تصمیم، مسیر حل را کاملاً تغییر میدهد.
- پیشپردازش داده مهمتر از خود الگوریتم است. بیشتر اشتباهات در حل تمرینها نه در انتخاب مدل، بلکه در نرمالسازی، مدیریت دادههای گمشده و کدگذاری متغیرهای کیفی رخ میدهد.
- همیشه نتیجه را تفسیر کنید، نه فقط محاسبه. در امتحانات و پروژهها، تفسیر خروجی (مثلاً معنای یک قانون انجمنی) امتیاز بیشتری نسبت به محاسبهی صرف دارد.
۶ نمونه کامل حل تمرین دادهکاوی
مثال ۱: طبقهبندی با درخت تصمیم (Decision Tree)
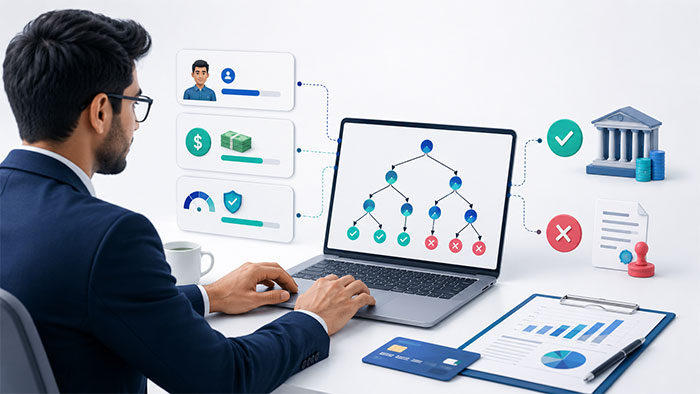
مسئله: یک بانک میخواهد بر اساس سن، درآمد و سابقهی اعتباری مشتریان، پیشبینی کند که آیا وام درخواستی تأیید میشود یا خیر.
گامهای حل:
۱. ابتدا متغیر هدف را مشخص کنید: «تأیید وام» با دو مقدار بله/خیر.
۲. برای هر ویژگی (سن، درآمد، سابقه اعتباری)، میزان بهرهی اطلاعاتی (Information Gain) یا کاهش آنتروپی را محاسبه کنید.
۳. ویژگیای که بیشترین بهرهی اطلاعاتی را دارد، به عنوان گرهی ریشه انتخاب میشود. در این مثال معمولاً «سابقه اعتباری» بیشترین تأثیر را دارد.
۴. درخت را به صورت بازگشتی برای هر شاخه ادامه دهید تا زمانی که گرهها خالص شوند یا معیار توقف برسد.
۵. برای جلوگیری از بیشبرازش (Overfitting)، درخت را با روش Pruning هرس کنید.
نکتهای که کمتر گفته میشود: بسیاری در محاسبهی آنتروپی دچار اشتباه محاسباتی میشوند چون فرمول لگاریتم پایه ۲ را با پایه ۱۰ اشتباه میگیرند. همیشه پیش از محاسبه، پایهی مورد استفاده در سؤال را بررسی کنید.
حل عددی کامل:
| مشتری | سن | درآمد | سابقه اعتباری | وام تأیید شد؟ |
| ۱ | جوان | پایین | بد | خیر |
| ۲ | جوان | بالا | خوب | بله |
| ۳ | میانسال | بالا | خوب | بله |
| ۴ | مسن | پایین | خوب | بله |
| ۵ | مسن | بالا | بد | خیر |
| ۶ | میانسال | پایین | بد | خیر |
| ۷ | جوان | بالا | بد | خیر |
| ۸ | مسن | بالا | خوب | بله |
از ۸ نمونه، ۴ مورد «بله» و ۴ مورد «خیر» است، پس آنتروپی کل مجموعه برابر است با:
Entropy(S) = −(4/8)×log₂(4/8) − (4/8)×log₂(4/8) = −0.5×(−1) − 0.5×(−1) = ۱
حالا داده را بر اساس «سابقه اعتباری» تقسیم میکنیم:
- شاخهی «خوب»: مشتریان ۲، ۳، ۴، ۸ ←هر ۴ نفر «بله» ←Entropy = ۰
- شاخهی «بد»: مشتریان ۱، ۵، ۶، ۷ ←هر ۴ نفر «خیر» ←Entropy = ۰
بهرهی اطلاعاتی:
Information Gain = 1 − [(4/8)×0 + (4/8)×0] = ۱
چون بهرهی اطلاعاتی برابر با حداکثر مقدار ممکن (۱) است، «سابقه اعتباری» بهتنهایی و بدون نیاز به هیچ ویژگی دیگری، کل داده را بهصورت خالص تفکیک میکند و به عنوان گرهی ریشهی درخت انتخاب میشود. در نتیجه درخت نهایی فقط یک سطح دارد: اگر سابقه اعتباری «خوب» باشد ←وام تأیید میشود؛ در غیر این صورت ←رد میشود.
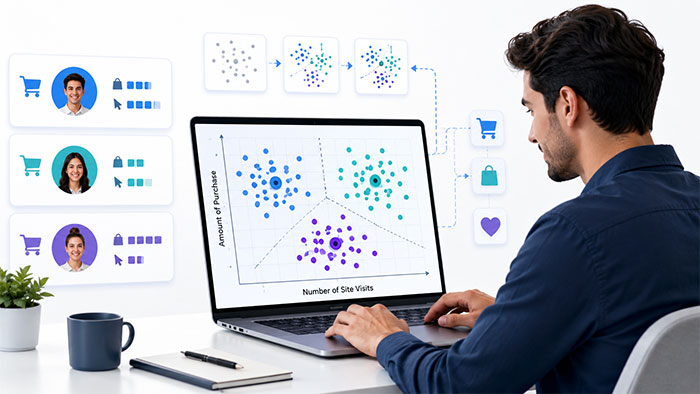
مثال ۲: خوشهبندی با الگوریتم K-Means
مسئله: یک فروشگاه آنلاین میخواهد مشتریان را بر اساس میزان خرید و تعداد بازدید از سایت به سه گروه تقسیم کند.
گامهای حل:
۱. تعداد خوشهها (k=3) را انتخاب کنید. این عدد یا در صورت سؤال داده شده، یا با روش Elbow تعیین میشود.
۲. سه مرکز خوشهی اولیه را به صورت تصادفی انتخاب کنید.
۳. فاصلهی اقلیدسی هر نقطه از مراکز خوشه را محاسبه کرده و هر نقطه را به نزدیکترین مرکز اختصاص دهید.
۴. میانگین نقاط هر خوشه را دوباره محاسبه کرده و مرکز جدید را جایگزین کنید.
۵. مراحل ۳ و ۴ را تا زمانی که مراکز خوشه دیگر تغییر نکنند، تکرار کنید.
نکتهای که کمتر گفته میشود: انتخاب مراکز اولیه بهصورت تصادفی میتواند نتیجهی نهایی را تغییر دهد. در تمرینهای امتحانی، همیشه فرض اولیهی دادهشده در سؤال را رعایت کنید، نه فرضی که خودتان انتخاب میکنید.
حل عددی کامل:
| مشتری | خرید (واحد صد هزار تومان) | تعداد بازدید |
| C1 | ۲ | ۳ |
| C2 | ۳ | ۳ |
| C3 | ۶ | ۶ |
| C4 | ۸ | ۸ |
| C5 | ۲ | ۴ |
| C6 | ۷ | ۷ |
فرض کنید k=2 و مراکز اولیه، C1(۲،۳) و C4(۸،۸) باشند.
تکرار اول — محاسبه فاصلهی اقلیدسی هر نقطه تا دو مرکز:
| مشتری | فاصله تا مرکز ۱ | فاصله تا مرکز ۲ | خوشه |
| C1 | ۰ | ۷.۸۱ | ۱ |
| C2 | ۱.۰۰ | ۷.۰۷ | ۱ |
| C3 | ۵.۰۰ | ۲.۸۳ | ۲ |
| C4 | ۷.۸۱ | ۰ | ۲ |
| C5 | ۱.۰۰ | ۷.۲۱ | ۱ |
| C6 | ۶.۴۰ | ۱.۴۱ | ۲ |
مراکز جدید بر اساس میانگین اعضای هر خوشه:
- خوشه ۱ (C1, C2, C5): مرکز جدید = ((۲+۳+۲)/۳ , (۳+۳+۴)/۳) = (۲.۳۳ , ۳.۳۳)
- خوشه ۲ (C3, C4, C6): مرکز جدید = ((۶+۸+۷)/۳ , (۶+۸+۷)/۳) = (۷ , ۷)
تکرار دوم: با محاسبهی مجدد فاصلهها از مراکز جدید، هر ۶ مشتری دقیقاً در همان خوشهی قبلی باقی میمانند، یعنی الگوریتم همگرا شده است. نتیجهی نهایی: مشتریان C1، C2 و C5 یک گروه «کمخرید» و مشتریان C3، C4 و C6 یک گروه «پرخرید و فعال» را تشکیل میدهند.
مثال ۳: قوانین انجمنی (Association Rules) و تحلیل سبد خرید
مسئله: بررسی تراکنشهای یک سوپرمارکت برای یافتن الگوهایی مانند «مشتریانی که نان میخرند، اغلب کره هم میخرند».
گامهای حل:
۱. مقدار Support برای هر مجموعه آیتم را محاسبه کنید: تعداد تراکنشهایی که آن آیتمها را با هم دارند، تقسیم بر کل تراکنشها.
۲. مقدار Confidence قانون A→B را محاسبه کنید: Support(A,B) تقسیم بر Support(A).
۳. مقدار Lift را برای سنجش قدرت واقعی رابطه محاسبه کنید. اگر Lift بیشتر از ۱ باشد، رابطه معنادار است.
۴. الگوریتم Apriori را برای حذف مجموعههای کمتکرار (زیر آستانه Minimum Support) اعمال کنید.
نکتهای که کمتر گفته میشود: خیلیها Confidence بالا را با یک رابطهی معنادار اشتباه میگیرند. یک قانون میتواند Confidence بالا داشته باشد اما Lift آن نزدیک یا کمتر از ۱ باشد، یعنی در واقع هیچ رابطهی واقعی وجود ندارد.
حل عددی کامل:
| تراکنش | آیتمهای خریداریشده |
| T1 | نان، کره، شیر |
| T2 | نان، کره |
| T3 | نان، شیر |
| T4 | کره، شیر |
| T5 | نان، کره، شیر |
از مجموع ۵ تراکنش، محاسبات مربوط به قانون «نان ←کره» به این صورت است:
- Support(نان) = ۴ از ۵ تراکنش = ۰.۸
- Support(کره) = ۴ از ۵ تراکنش = ۰.۸
- Support(نان و کره با هم) = ۳ از ۵ تراکنش (T1, T2, T5) = ۰.۶
- Confidence(نان ←کره) = Support(نان,کره) ÷ Support(نان) = ۰.۶ ÷ ۰.۸ = ۰.۷۵ (۷۵٪)
- Lift(نان ←کره) = Confidence ÷ Support(کره) = ۰.۷۵ ÷ ۰.۸ = ۰.۹۳۷
با اینکه Confidence این قانون ۷۵٪ و در نگاه اول بالا به نظر میرسد، مقدار Lift کمتر از ۱ است. این یعنی خرید نان عملاً احتمال خرید کره را افزایش نمیدهد — دو آیتم صرفاً به این دلیل با هم دیده میشوند که هر دو در کل تراکنشها پرتکرار هستند، نه به این دلیل که واقعاً به هم مرتبطاند. این دقیقاً همان اشتباهی است که در نکتهی بالا به آن اشاره شد.
مثال ۴: رگرسیون خطی برای پیشبینی
مسئله: پیشبینی قیمت یک آپارتمان بر اساس متراژ آن.
گامهای حل:
۱. دادهها را روی نمودار پراکندگی رسم کنید تا رابطهی خطی بودن یا نبودن بررسی شود.
۲. با روش کمترین مربعات خطا (Least Squares) ضرایب خط رگرسیون (شیب و عرض از مبدأ) را محاسبه کنید.
۳. معادلهی خط را برای پیشبینی مقادیر جدید استفاده کنید.
۴. کیفیت مدل را با معیار R² (ضریب تعیین) ارزیابی کنید.
نکتهای که کمتر گفته میشود: مقدار R² بالا همیشه به معنای مدل خوب نیست. اگر داده کم باشد یا متغیرهای دیگری در قیمت تأثیرگذار باشند (مثل موقعیت مکانی)، مدل ساده رگرسیون خطی میتواند گمراهکننده باشد.
حل عددی کامل:
| آپارتمان | متراژ (متر مربع) | قیمت (میلیون تومان) |
| ۱ | ۵۰ | ۵۰۰ |
| ۲ | ۶۰ | ۶۰۰ |
| ۳ | ۷۰ | ۶۵۰ |
| ۴ | ۸۰ | ۷۵۰ |
| ۵ | ۱۰۰ | ۹۰۰ |
میانگین متراژ = ۷۲ و میانگین قیمت = ۶۸۰. با فرمول کمترین مربعات خطا:
شیب خط (b) = Σ[(x−x̄)(y−ȳ)] ÷ Σ[(x−x̄)²] = ۱۱۷۰۰ ÷ ۱۴۸۰ = ۷.۹۱
عرض از مبدأ (a) = ȳ − b×x̄ = ۶۸۰ − (۷.۹۱ × ۷۲) = ۱۱۰.۸
معادلهی خط رگرسیون: قیمت = ۱۱۰.۸ + ۷.۹۱ × متراژ
با این معادله، قیمت یک آپارتمان ۹۰ متری اینگونه پیشبینی میشود:
قیمت = ۱۱۰.۸ + (۷.۹۱ × ۹۰) = ۱۱۰.۸ + ۷۱۱.۹ ≈ ۸۲۲.۷ میلیون تومان
با محاسبهی مجموع مربعات خطا و مجموع مربعات کل، مقدار R² این مدل تقریباً ۰.۹۹۴ بهدست میآید؛ یعنی حدود ۹۹.۴٪ از تغییرات قیمت با متراژ توضیح داده میشود که نشاندهندهی برازش بسیار قوی مدل خطی روی این دادهی خاص است.
مثال ۵: تشخیص دادههای پرت (Outlier Detection)
مسئله: در یک دیتاست تراکنشهای بانکی، تراکنشهای مشکوک به تقلب را شناسایی کنید.
گامهای حل:
۱. میانگین و انحراف معیار داده را محاسبه کنید.
۲. با استفاده از روش Z–Score، هر دادهای که بیش از ۳ انحراف معیار از میانگین فاصله دارد را به عنوان دادهی پرت علامتگذاری کنید.
۳. بهعنوان روش جایگزین، از IQR (دامنهی میانچارکی) استفاده کنید: هر مقداری خارج از بازه Q1-1.5×IQR تا Q3+1.5×IQR پرت محسوب میشود.
۴. دادههای پرت را بررسی کنید تا مشخص شود خطای ثبت داده هستند یا واقعاً یک الگوی غیرعادی (مثل تقلب) را نشان میدهند.
نکتهای که کمتر گفته میشود: حذف خودکار همهی دادههای پرت اشتباه است. در بسیاری از مسائل واقعی (مثل تشخیص تقلب)، خودِ دادهی پرت هدف اصلی تحلیل است، نه یک نویز که باید حذف شود.
حل عددی کامل:
مبلغ ۸ تراکنش (به هزار تومان): ۴۸، ۴۹، ۵۰، ۵۱، ۵۲، ۵۳، ۵۵، ۷۰۰
میانگین = ۱۳۲.۲۵ و انحراف معیار ≈ ۲۱۴.۶
Z-Score تراکنش مشکوک (۷۰۰):
Z = (۷۰۰ − ۱۳۲.۲۵) ÷ ۲۱۴.۶ = ۲.۶۵
نکتهی مهم اینجاست: عدد ۲.۶۵ از آستانهی رایج ۳ کمتر است، پس ممکن است این روش این تراکنش را «پرت» تشخیص ندهد! دلیل آن این است که همان مقدار ۷۰۰ خودش میانگین و انحراف معیار را بهشدت بالا کشیده است — این یکی از ضعفهای شناختهشدهی Z-Score در نمونههای کوچک است.
حالا همین داده را با روش I QR بررسی میکنیم:
- چارک اول (Q1) ≈ ۴۹.۲۵
- چارک سوم (Q3) ≈ ۵۴.۵
- IQR = Q3 − Q1 = ۵.۲۵
- سقف مجاز = Q3 + 1.5×IQR = ۵۴.۵ + ۷.۸۸ = ۶۲.۳۸
چون مقدار ۷۰۰ بهوضوح از سقف ۶۲.۳۸ بزرگتر است، روش IQR این تراکنش را بهدرستی به عنوان دادهی پرت شناسایی میکند. این مثال دقیقاً نشان میدهد چرا در دیتاستهای کوچک یا دارای پرتهای شدید، IQR معمولاً قابلاعتمادتر از Z-Score است.
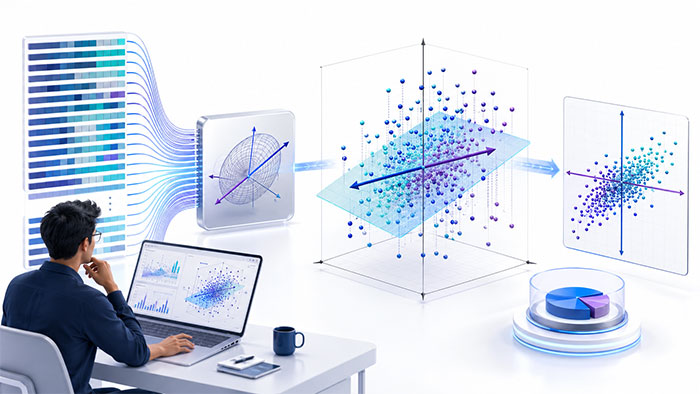
مثال ۶: کاهش ابعاد با تحلیل مؤلفههای اصلی (PCA)
مسئله: یک دیتاست با ۲۰ متغیر دارید و میخواهید آن را برای تجسم بهتر به دو بعد کاهش دهید.
گامهای حل:
۱. دادهها را استانداردسازی کنید (میانگین صفر، واریانس یک).
۲. ماتریس کوواریانس بین متغیرها را محاسبه کنید.
۳. مقادیر ویژه (Eigenvalues) و بردارهای ویژه (Eigenvectors) را استخراج کنید.
۴. مؤلفههایی که بیشترین واریانس داده را توضیح میدهند (معمولاً دو یا سه مؤلفه اول) را انتخاب کنید.
۵. دادهی اصلی را روی این مؤلفههای جدید تصویر کنید.
نکتهای که کمتر گفته میشود: PCA فقط یک روش کاهش بعد نیست، بلکه ابزاری قدرتمند برای حذف همخطی چندگانه (Multicollinearity) پیش از اجرای مدلهای رگرسیونی است؛ نکتهای که در اکثر تمرینهای دانشگاهی نادیده گرفته میشود.
حل عددی کامل (نسخهی سادهشده با ۲ متغیر):
| نمونه | متغیر X | متغیر Y |
| ۱ | ۲.۵ | ۲.۴ |
| ۲ | ۰.۵ | ۰.۷ |
| ۳ | ۲.۲ | ۲.۹ |
| ۴ | ۱.۹ | ۲.۲ |
| ۵ | ۳.۱ | ۳.۰ |
میانگین X = ۲.۰۴ و میانگین Y = ۲.۲۴. پس از مرکزیکردن داده و محاسبهی ماتریس کوواریانس:
Cov(X,X) = ۰.۹۳۸ — Cov(Y,Y) = ۰.۸۵۳ — Cov(X,Y) = ۰.۸۴۱
با حل معادلهی مقادیر ویژه روی این ماتریس، دو مقدار ویژه بهدست میآید:
- λ۱ = ۱.۷۳۷ (مؤلفهی اصلی اول)
- λ۲ = ۰.۰۵۴ (مؤلفهی اصلی دوم)
درصد واریانس توضیحدادهشده توسط مؤلفهی اول:
λ۱ ÷ (λ۱ + λ۲) = ۱.۷۳۷ ÷ ۱.۷۹۱ ≈ ۹۷٪
یعنی تنها با نگهداشتن یک بُعد (مؤلفهی اول) بهجای دو متغیر اصلی، حدود ۹۷٪ از اطلاعات داده حفظ میشود. در دیتاستهای واقعی با ۲۰ متغیر، همین منطق برای انتخاب دو یا سه مؤلفهی برتر از میان تمام مؤلفهها استفاده میشود.

مقایسه ی ۶ روش دادهکاوی
| روش | نوع داده هدف | کاربرد اصلی | سطح پیچیدگی |
| درخت تصمیم | برچسبدار (Classification) | پیشبینی دسته | متوسط |
| K-Means | بدون برچسب (Clustering) | گروهبندی مشتریان | متوسط |
| قوانین انجمنی | تراکنشی | تحلیل سبد خرید | ساده تا متوسط |
| رگرسیون خطی | عددی پیوسته | پیشبینی مقدار | ساده |
| تشخیص داده پرت | آماری | شناسایی تقلب/خطا | متوسط |
| PCA | چندبعدی | کاهش ابعاد و تجسم | بالا |
اشتباهات رایج در حل تمرینهای دادهکاوی
- انتخاب الگوریتم بدون بررسی نوع متغیر هدف (کیفی یا کمی بودن آن).
- نادیده گرفتن نرمالسازی داده قبل از اجرای الگوریتمهای مبتنی بر فاصله مثل K-Means .
- تفسیر نکردن نتیجهی نهایی و بسنده کردن به محاسبهی عددی صرف.
- استفاده از کل داده برای آموزش مدل، بدون تفکیک داده آموزش و آزمون.
- اشتباه گرفتن همبستگی با رابطهی علّی در تفسیر نتایج رگرسیون یا قوانین انجمنی.
سوالات متداول
۱. برای شروع یادگیری دادهکاوی، از کدام الگوریتم شروع کنم؟ درخت تصمیم و K-Means بهترین نقطهی شروع هستند چون هم مفهومی ساده دارند و هم پایهی بسیاری از روشهای پیشرفتهتر محسوب میشوند.
۲. آیا برای حل تمرین دادهکاوی حتماً باید کدنویسی بلد باشم؟ برای درک مفهومی و حل تمرینهای دستی، نه. اما برای اجرای واقعی روی دیتاستهای بزرگ، آشنایی با پایتون (کتابخانههای Pandas و Scikit-learn) بسیار کمککننده است.
۳. تفاوت دادهکاوی و یادگیری ماشین چیست؟ دادهکاوی بیشتر بر کشف الگوهای پنهان در دادههای موجود تمرکز دارد، در حالی که یادگیری ماشین بر ساخت مدلهایی برای پیشبینی دادههای جدید تأکید میکند؛ هرچند این دو حوزه همپوشانی زیادی دارند.
۴. چرا در K-Means نتیجه هر بار متفاوت میشود؟ چون مراکز اولیه بهصورت تصادفی انتخاب میشوند. برای نتیجهی پایدارتر میتوان الگوریتم را چند بار اجرا کرد و بهترین نتیجه را بر اساس کمترین خطای درونخوشهای انتخاب کرد.
۵. کدام روش برای دادههای کمحجم مناسبتر است؟ درخت تصمیم و رگرسیون خطی برای دادههای کوچک عملکرد بهتری دارند، در حالی که روشهایی مانند PCA به حجم دادهی بیشتری برای نتیجهی معنادار نیاز دارند.
۶. آیا Lift همیشه معیار بهتری از Confidence است؟ بله، بهطور کلی Lift معیار قابل اعتمادتری است چون رابطهی واقعی بین آیتمها را نشان میدهد، در حالی که Confidence میتواند به دلیل فراوانی بالای یک آیتم بهتنهایی، گمراهکننده باشد.
شاید موضوع این مقالات برایتان جالب باشد:
جمعبندی
حل تمرین دادهکاوی زمانی معنا پیدا میکند که فراتر از فرمولها، به منطق پشت هر روش فکر کنید: چرا این الگوریتم انتخاب شده، داده چه ویژگیهایی دارد و نتیجهی نهایی چه معنایی برای مسئلهی واقعی دارد. شش مثالی که در این مقاله بررسی شد، پرکاربردترین حوزههای دادهکاوی یعنی طبقهبندی، خوشهبندی، قوانین انجمنی، رگرسیون، تشخیص داده پرت و کاهش ابعاد را پوشش میدهند.
اگر این مثالها را با دقت مرور کنید و اشتباهات رایج ذکرشده را در تمرینهای خودتان رعایت کنید، نهتنها در امتحانات و پروژههای دانشگاهی عملکرد بهتری خواهید داشت، بلکه پایهی محکمی برای ورود به دنیای واقعی تحلیل داده و علم داده به دست میآورید.


